Intel GPU D 系列在 OCP 2026 全球峰會正式亮相,單卡最高 480GB 記憶體、可支援 3,000 億參數模型,鎖定代理式 AI 時代的大規模推論需求。這篇整理新品規格、Xeon 機櫃設計與開放式軟體布局,幫你快速理解英特爾如何搶攻下一波 AI 基礎架構商機。
文章目錄
- 重點整理
- Intel GPU D 系列:專為大規模推論打造
- Intel GPU D 系列規格一覽
- Intel Xeon 機櫃:代理式 AI 的運算基礎
- Intel GPU D 系列與開放式軟體生態
- 我們的看法
重點整理
- Intel GPU D 系列(代號 Crescent Island)正式公布規格,採用 Xe3P 架構,350W 功耗內提供最高 480 GB LPDDR5X 記憶體
- 單卡可跑 3,000 億參數模型,八卡系統支援超過 1 兆參數,瞄準大型語言模型與長上下文推論
- Xeon 機櫃設計採用 Open Rack v3(ORv3)標準,單一機櫃核心數可超過 46,000 個
- 已開始提供客戶樣品,採用標準 PCIe 與氣冷設計,不需專用機櫃或特殊冷卻
- 英特爾自 2011 年起已向開放運算計畫(OCP)貢獻 116 項成果
Intel GPU D 系列:專為大規模推論打造
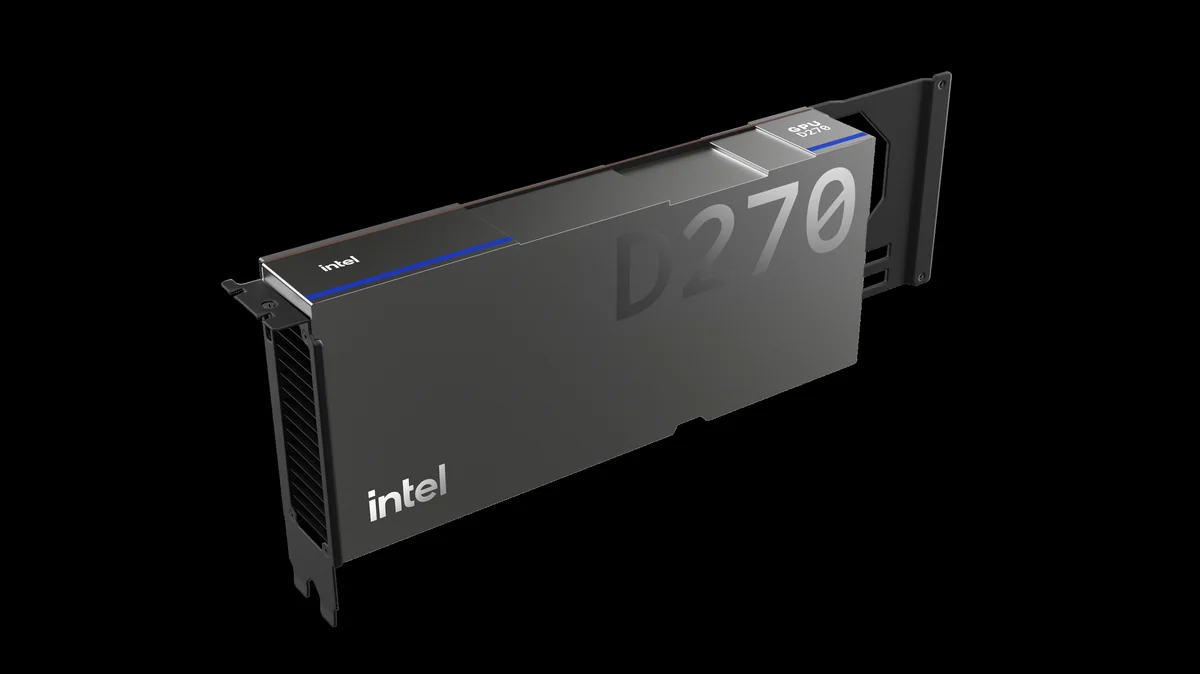
英特爾在開放運算計畫(Open Compute Project)全球峰會上,公布 Intel GPU D 系列(代號 Crescent Island)的最新技術細節。這款 GPU 鎖定的是長時間運行、記憶體密集型的 AI 推論工作負載,與過去主打訓練的加速器路線明顯不同——用更低功耗、更高記憶體容量,換取更具成本效益的推論能力。
代理式 AI(Agentic AI)正把推論轉變為多步驟工作流程,涵蓋資訊檢索、推理、協調、工具使用與執行,這些任務對記憶體容量與資料吞吐的要求遠高於傳統單次問答。Intel GPU D 系列透過 Xe3P 架構與 LPDDR5X 記憶體組合,在 350 瓦功耗內提供最高 480 GB 記憶體,單張卡即可載入多達 3,000 億參數的模型,八卡系統更可支援超過 1 兆參數的巨型模型。
值得注意的是,Intel GPU D 系列採用標準 PCIe 介面與氣冷式設計,並共用 Xe 軟體基礎,企業不需要建置專用機櫃或特殊冷卻基礎設施,就能在既有資料中心環境中部署,也降低了從其他 Intel GPU 平台移植應用程式的門檻。目前該產品已開始提供客戶樣品。
Intel GPU D 系列規格一覽
| 項目 | Intel GPU D 系列規格 |
|---|---|
| 架構 | Xe3P |
| 記憶體 | 最高 480 GB LPDDR5X |
| 記憶體頻寬 | 1.5 TB/s |
| 運算效能 | 最高 1.3 petaflops(FP8) |
| 功耗 | 350 瓦 |
| 模型支援 | 單卡最高 3,000 億參數;八卡超過 1 兆參數 |
| 介面 | 標準 PCIe、氣冷式設計 |
| 適用場景 | 多租戶 AI 服務、機器人、長上下文推論 |
英特爾資料中心事業群 AI 產品與市場策略副總裁 Anil Nanduri 表示,推論正成為 AI 最具代表性的工作負載,企業需要能以合理成本提供適當效能的基礎架構,Intel GPU D 系列就是為了讓高容量推論更容易部署、更具成本效益。
Intel Xeon 機櫃:代理式 AI 的運算基礎
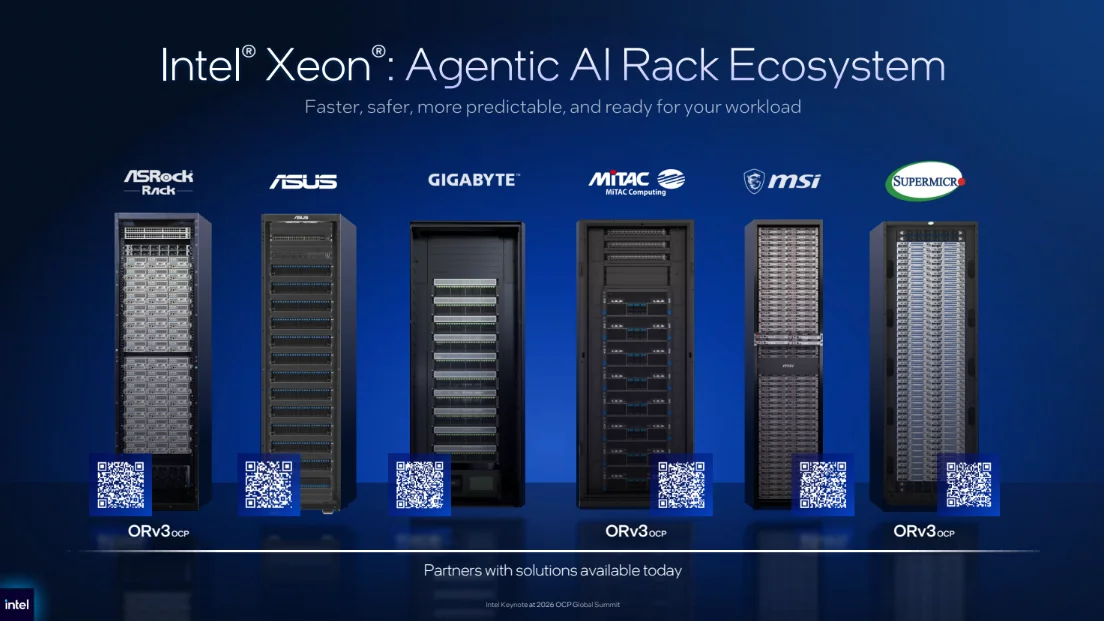
除了 GPU,英特爾同步展示與生態系夥伴共同開發、採用 Xeon 處理器的全新機櫃設計,其中許多設計遵循開放運算計畫的 Open Rack v3(ORv3)標準,便於在開放式資料中心基礎架構中部署與整合。部分 Xeon 6+ 配置可讓單一機櫃核心數超過 46,000 個,機櫃總功耗 133.45 kW。
在代理式 AI 的工作流程中,通用運算必須承擔協調工作負載、處理資料、管理 I/O 等任務,確保加速器持續發揮效能。英特爾強調,Xeon 的角色就是與 GPU 及專用加速器協同運作,維持資料順暢流動、工具持續執行,讓系統在符合延遲要求下,最大化同一機櫃能同時運作的 AI 代理數量。
Intel GPU D 系列與開放式軟體生態
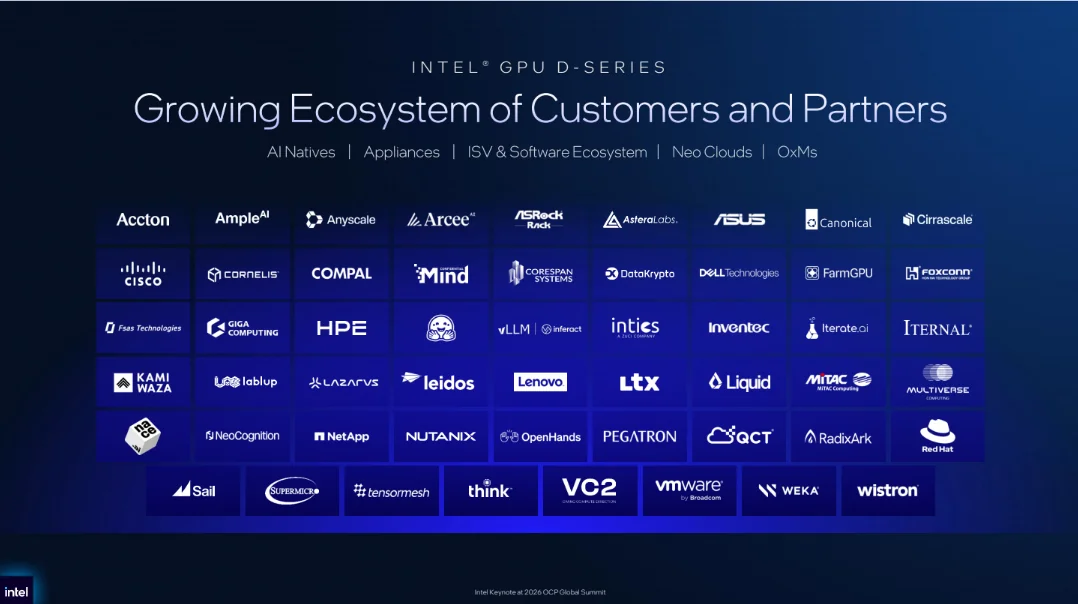
要讓異質 AI 基礎架構大規模運作,開放軟體是串聯不同運算資源的關鍵。英特爾的策略是在業界標準 AI 框架、推論執行環境與部署環境的上游專案中,原生整合對 CPU 與 GPU 的支援,讓開發者能沿用既有工具。近期成果包括在 Meta 的 Muse Glimmer 發布首日即提供支援。
- 共通 Xe 軟體基礎:Intel GPU D 系列可沿用既有 Intel GPU 平台的應用程式,降低部署門檻
- 開放框架支援:主流 AI 框架與服務引擎皆支援,同一套軟體也適用於 Xeon 上的推論
- 企業工具就緒:Intel AI for Enterprise Agent Toolkit 已針對 Xeon 最佳化,可延伸支援 Intel GPU,為多模態工作流程提供彈性基礎
英特爾也透過 Open Adapter Card 工作小組,與產業夥伴共同制定適用於機櫃內部署的標準化加速器卡規格,提升不同系統設計在機構、電氣與管理層面的互通性。自 2011 年以來,英特爾已向 OCP 貢獻 116 項成果,讓企業能在既有投資的基礎上持續演進 AI 系統,不必從頭開始。
我們的看法
英特爾這步棋的關鍵,在於把 AI 推論的戰場從「誰的訓練算力最強」拉到「誰能以最低成本服務最多的推論請求」。代理式 AI 的興起讓推論次數暴增,記憶體容量與頻寬反而比峰值運算更重要,Intel GPU D 系列用 480 GB 記憶體搭配 350 瓦功耗,確實抓到了這個需求的痛點。
不過,我們也必須誠實看待兩點:第一,Intel GPU D 系列目前仍在客戶樣品階段,實際量產與出貨時間未定,對手 NVIDIA 在資料中心 AI 的軟體生態系與市占優勢依然明顯;第二,推論市場的競爭才剛開始,AMD 與各家雲端自研晶片同樣虎視眈眈,英特爾能否把規格優勢轉為實際訂單,還要觀察後續生態系夥伴的採用進度。對一般讀者來說,這場競爭長期而言是好事——更多選擇與更低的 AI 服務成本,最終都會反映在你每天使用的 AI 產品上。